Domain web-crawler.de kaufen?
Wir ziehen mit dem Projekt
web-crawler.de um.
Sind Sie am Kauf der Domain
web-crawler.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain web-crawler.de kaufen?
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
Ähnliche Suchbegriffe für Vision-basierte-Deep-Web-Datenextraktion-für-Web-Dokument-Clustering
Top-Angebote
Produkte zum Begriff Vision-basierte-Deep-Web-Datenextraktion-für-Web-Dokument-Clustering:
-
Richards, Douglas E.: Brain WebBrain Web , Nick Hall, ausgestattet mit revolutionären Gehirnimplantaten, kann mit seinem Geist Gedanken lesen und auf das Internet zugreifen. Als eine skrupellose Terrorgruppe damit droht, internationale Stars live und vor den Augen der Welt zu töten, ist Nick die einzige Rettung. Doch stattdessen wird er zur Zielscheibe der mächtigsten Kräfte der Welt und erlebt einen schmerzhaften Verrat in seinem engsten Kreis - ein brutales Rennen gegen die Zeit beginnt! 'Gedankennetz' basiert auf den realen Forschungen zu neuronalen Implantaten von Pionieren wie Elon Musk (Neuralink). , Direktstarter (DOL) > Motorstarter , Erscheinungsjahr: 20241027, Produktform: Software, Titel der Reihe: Nick Hall#2#, Autoren: Richards, Douglas E., Übersetzung: Würz, Manuela, Vorleser: Reinbold, Marco Sven, Themenüberschrift: FICTION / Thrillers / Technological, Keyword: biotechnologie; gentechnik; high-tech; high-tech thriller; nanotechnologie; sci fi thriller; science fiction spannend; spionage; tech thriller; technologie; thriller; verbrechen; zukunft; überwachung, Fachschema: Amerikanische Belletristik / Kriminalroman~Hörbuch / Kriminalroman, Fachkategorie: Technothriller~Science-Fiction: Nahe Zukunft~Belletristik in Übersetzung~Kriminalromane und Mystery, Warengruppe: AUDIO/Belletristik/Kriminalromane, Fachkategorie: Moderne und zeitgenössische Belletristik, Sekunden: 802, UNSPSC: 85234920, Warenverzeichnis für die Außenhandelsstatistik: 85234920, Verlag: Omondi UG, Verlag: Omondi UG, Verlag: Ronin-Hrverlag, Produktverfügbarkeit: 02, Länge: 124, Breite: 142, Höhe: 10, Gewicht: 102, Produktform: MP3, Genre: Hörbücher, Genre: Hörbuch,26,62 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie lautet der Oberbegriff für die folgenden Dinge: Deep Web, Darknet, World Wide Web, Web?
Der Oberbegriff für die genannten Dinge ist "Internet". Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen zugänglich ist, während das Darknet auf anonyme Kommunikation und den Zugang zu illegalen Inhalten abzielt. Das World Wide Web ist der öffentliche Teil des Internets, in dem Websites und Webseiten zugänglich sind. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Was ist das Deep Web?
Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen wie Google zugänglich ist. Es umfasst Websites, die nicht indexiert sind und daher nicht einfach gefunden werden können. Das Deep Web enthält oft sensible Informationen wie private Datenbanken, geschützte Websites und andere nicht öffentliche Inhalte. **
-
Wie funktioniert das Deep Web?
Das Deep Web ist der Teil des Internets, der nicht über Suchmaschinen wie Google oder Bing zugänglich ist. Es umfasst Websites, die nicht indexiert sind und daher nicht einfach gefunden werden können. Um auf das Deep Web zuzugreifen, benötigt man spezielle Software wie den Tor-Browser, der die Anonymität der Nutzer schützt. Dort können Nutzer auf verschlüsselte Websites zugreifen, die sensible Informationen enthalten oder für illegale Aktivitäten genutzt werden. Es ist wichtig zu beachten, dass das Deep Web nicht dasselbe ist wie das Darknet, das einen kleinen Teil des Deep Webs ausmacht und für illegale Aktivitäten bekannt ist. **

Was ist der Unterschied zwischen dem Deep Web und dem Dark Web?
Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen zugänglich ist und private oder geschützte Informationen enthält, wie zum Beispiel E-Mails oder Online-Banking. Das Dark Web hingegen ist ein Teil des Deep Webs, der absichtlich verborgen bleibt und für illegale Aktivitäten genutzt wird, wie zum Beispiel den Handel mit Drogen oder Waffen. Der Zugang zum Dark Web erfordert spezielle Software und Anonymitätstools wie Tor. **
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
Top-Angebote
Produkte zum Begriff Vision-basierte-Deep-Web-Datenextraktion-für-Web-Dokument-Clustering:
-
Vision-basierte Deep-Web-Datenextraktion für Web-Dokument-Clustering, Taschenbuch von M. Lavanya, Verlag Unser Wissen, 978-620-5-02342-6Vision-basierte Deep-web-datenextraktion Für Web-dokument-clustering, Taschenbuch Von M. Lavanya, Verlag Unser Wissen, 978-620-5-02342-6, Seitenanzahl: 20079,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Web-Datenextraktion der Kompetenzen von Universitätsmitarbeitern, Taschenbuch von Edin Zildzo, Verlag Unser Wissen, 978-620-9-77521-5Web-datenextraktion Der Kompetenzen Von Universitätsmitarbeitern, Taschenbuch Von Edin Zildzo, Verlag Unser Wissen, 978-620-9-77521-5, Seitenanzahl: 8448,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Richards, Douglas E.: Brain WebBrain Web , Nick Hall, ausgestattet mit revolutionären Gehirnimplantaten, kann mit seinem Geist Gedanken lesen und auf das Internet zugreifen. Als eine skrupellose Terrorgruppe damit droht, internationale Stars live und vor den Augen der Welt zu töten, ist Nick die einzige Rettung. Doch stattdessen wird er zur Zielscheibe der mächtigsten Kräfte der Welt und erlebt einen schmerzhaften Verrat in seinem engsten Kreis - ein brutales Rennen gegen die Zeit beginnt! 'Gedankennetz' basiert auf den realen Forschungen zu neuronalen Implantaten von Pionieren wie Elon Musk (Neuralink). , Direktstarter (DOL) > Motorstarter , Erscheinungsjahr: 20241027, Produktform: Software, Titel der Reihe: Nick Hall#2#, Autoren: Richards, Douglas E., Übersetzung: Würz, Manuela, Vorleser: Reinbold, Marco Sven, Themenüberschrift: FICTION / Thrillers / Technological, Keyword: biotechnologie; gentechnik; high-tech; high-tech thriller; nanotechnologie; sci fi thriller; science fiction spannend; spionage; tech thriller; technologie; thriller; verbrechen; zukunft; überwachung, Fachschema: Amerikanische Belletristik / Kriminalroman~Hörbuch / Kriminalroman, Fachkategorie: Technothriller~Science-Fiction: Nahe Zukunft~Belletristik in Übersetzung~Kriminalromane und Mystery, Warengruppe: AUDIO/Belletristik/Kriminalromane, Fachkategorie: Moderne und zeitgenössische Belletristik, Sekunden: 802, UNSPSC: 85234920, Warenverzeichnis für die Außenhandelsstatistik: 85234920, Verlag: Omondi UG, Verlag: Omondi UG, Verlag: Ronin-Hrverlag, Produktverfügbarkeit: 02, Länge: 124, Breite: 142, Höhe: 10, Gewicht: 102, Produktform: MP3, Genre: Hörbücher, Genre: Hörbuch,26,62 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
-
Wie lautet der Oberbegriff für die folgenden Dinge: Deep Web, Darknet, World Wide Web, Web?
Der Oberbegriff für die genannten Dinge ist "Internet". Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen zugänglich ist, während das Darknet auf anonyme Kommunikation und den Zugang zu illegalen Inhalten abzielt. Das World Wide Web ist der öffentliche Teil des Internets, in dem Websites und Webseiten zugänglich sind. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
Ähnliche Suchbegriffe für Vision-basierte-Deep-Web-Datenextraktion-für-Web-Dokument-Clustering
-
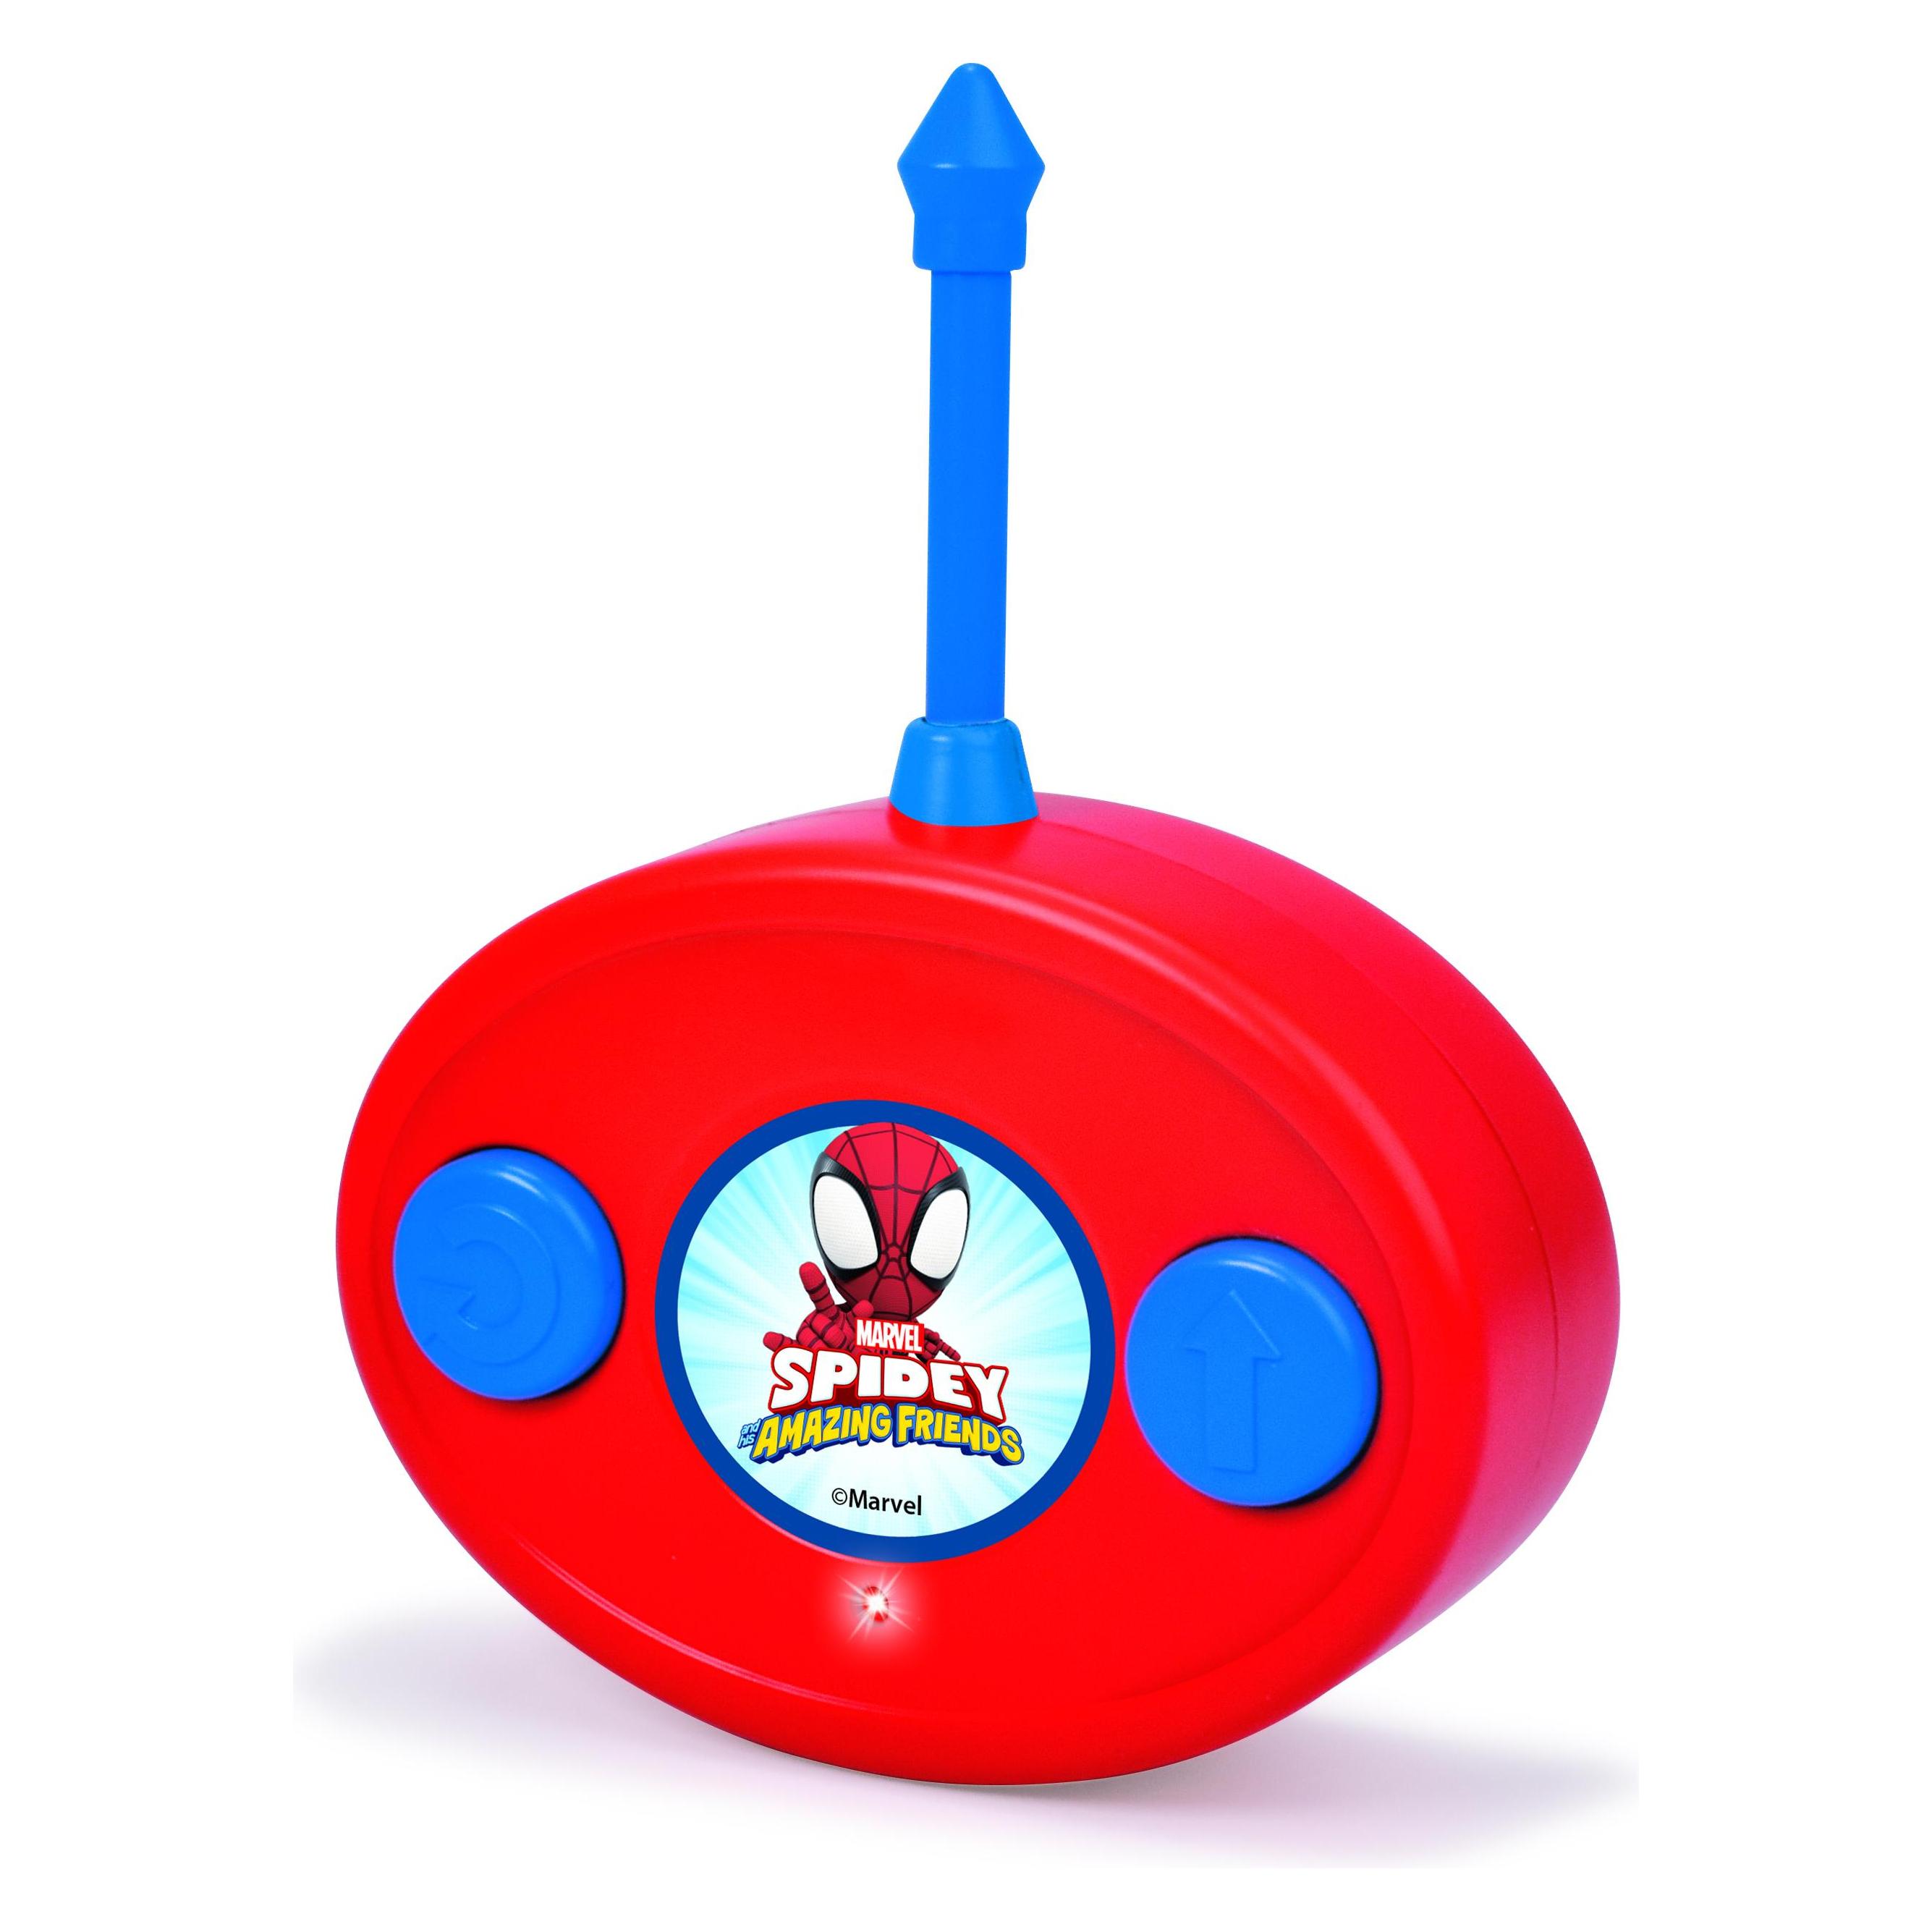
Marvel RC Spidey Web CrawlerFerngesteuertes Auto RC Spidey Web Crawler bietet 1-Kanal-27 MHz-Steuerung und Fahrfunktionen für Vorwärtsfahren und Rückwärtslenken. Dieses Marvel Spidey RC-Auto ist für Kinder ab 3 Jahren konzipiert und hat eine Länge von 17 cm für einfaches Spielen drinnen und unkomplizierte Handhabung. Marvel Spidey Thema 1-Kanal-Steuerung 27 MHz Fernsteuerfrequenz Fährt vorwärts Lenkt rückwärts Länge: 17 cm Empfohlenes Alter: ab 3 Jahren Einfache Steuerung und kompakte Größe machen es zu einem spaßigen, leicht zu bedienenden Marvel Spidey Fahrzeug für den Alltag.29,73 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Was ist das Deep Web?
Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen wie Google zugänglich ist. Es umfasst Websites, die nicht indexiert sind und daher nicht einfach gefunden werden können. Das Deep Web enthält oft sensible Informationen wie private Datenbanken, geschützte Websites und andere nicht öffentliche Inhalte. **
-
Wie funktioniert das Deep Web?
Das Deep Web ist der Teil des Internets, der nicht über Suchmaschinen wie Google oder Bing zugänglich ist. Es umfasst Websites, die nicht indexiert sind und daher nicht einfach gefunden werden können. Um auf das Deep Web zuzugreifen, benötigt man spezielle Software wie den Tor-Browser, der die Anonymität der Nutzer schützt. Dort können Nutzer auf verschlüsselte Websites zugreifen, die sensible Informationen enthalten oder für illegale Aktivitäten genutzt werden. Es ist wichtig zu beachten, dass das Deep Web nicht dasselbe ist wie das Darknet, das einen kleinen Teil des Deep Webs ausmacht und für illegale Aktivitäten bekannt ist. **
-
Was ist der Unterschied zwischen dem Deep Web und dem Dark Web?
Das Deep Web bezieht sich auf den Teil des Internets, der nicht über Suchmaschinen zugänglich ist und private oder geschützte Informationen enthält, wie zum Beispiel E-Mails oder Online-Banking. Das Dark Web hingegen ist ein Teil des Deep Webs, der absichtlich verborgen bleibt und für illegale Aktivitäten genutzt wird, wie zum Beispiel den Handel mit Drogen oder Waffen. Der Zugang zum Dark Web erfordert spezielle Software und Anonymitätstools wie Tor. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.