Domain web-crawler.de kaufen?
Wir ziehen mit dem Projekt
web-crawler.de um.
Sind Sie am Kauf der Domain
web-crawler.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain web-crawler.de kaufen?
Wie funktioniert die Indexierung und der Algorithmus einer Website-Suchmaschine? Welche Faktoren bestimmen die Relevanz der Suchergebnisse?
Die Indexierung einer Website-Suchmaschine erfolgt durch das Durchsuchen und Speichern von Webseiteninhalten in einer Datenbank. Der Algorithmus einer Suchmaschine bestimmt die Relevanz der Suchergebnisse anhand von Faktoren wie Keywords, Backlinks, Nutzerverhalten und Aktualität der Inhalte. Die Suchmaschine zeigt dann die Ergebnisse basierend auf diesen Faktoren in einer bestimmten Reihenfolge an. **
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **

Ähnliche Suchbegriffe für Algorithmus
Top-Angebote
Produkte zum Begriff Algorithmus:
-
Untersuchung, Implementierung und Einsatz des Levenberg-Marquardt-Algorithmus zur Analyse von Chip-Fertigungsdaten, Taschenbuch von Daniel Weisskopf,Untersuchung, Implementierung Und Einsatz Des Levenberg-marquardt-algorithmus Zur Analyse Von Chip-fertigungsdaten, Taschenbuch Von Daniel Weisskopf, Grin, 978-3-8386-1645-2, Seitenanzahl: 11238,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Zweig, Katharina: Ein Algorithmus hat kein TaktgefühlEin Algorithmus hat kein Taktgefühl , Wo künstliche Intelligenz sich irrt, warum uns das betrifft und was wir dagegen tun können , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Auflage: Originalausgabe, Erscheinungsjahr: 20191014, Produktform: Kartoniert, Titel der Reihe: Künstliche Intelligenz (Heyne)##, Autoren: Zweig, Katharina, Auflage/Ausgabe: Originalausgabe, Seitenzahl/Blattzahl: 320, Abbildungen: Illus im Text, Keyword: algorithmen; artificial intelligence; bestseller; bestsellerliste; buch; bücher; datenklau; demokratie; digitalisierung; facebook; google; internet; künstliche intelligenz; persönliche daten; roboter; spiegel bestseller; spiegel-bestseller; spiegelbestseller, Fachschema: Internet / Politik, Gesellschaft~Medientheorie~Medienwissenschaft~EDV / Gesellschaft u. Computer~EDV / Theorie / Recht~Recht (EDV)~Internet~Surfen (Internet)~Algorithmus~Datenschutz~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI, Fachkategorie: Ethische und soziale Fragen der IT~Rechtliche Fragen der IT~Internet, allgemein~Algorithmen und Datenstrukturen~Datenschutz~Künstliche Intelligenz, Thema: Verstehen, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Medienwissenschaften: Internet, digitale Medien und Gesellschaft, Thema: Optimieren, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Heyne Verlag, Verlag: Heyne Verlag, Verlag: Heyne, Länge: 206, Breite: 136, Höhe: 33, Gewicht: 417, Produktform: Klappenbroschur, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, eBook EAN: 9783641250232, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 193169520,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ein vorgeschlagener neuer Algorithmus für die Analyse des hierarchischen Clusterns, Taschenbuch von Saravanan Devaraj, Verlag Unser Wissen,Ein Vorgeschlagener Neuer Algorithmus Für Die Analyse Des Hierarchischen Clusterns, Taschenbuch Von Saravanan Devaraj, Verlag Unser Wissen, 978-620-6-53222-4, Seitenanzahl: 5635,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **

Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Internetinhalten?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links folgen und Webseiten analysieren. Sie sammeln Informationen über Webseiten und senden sie an Suchmaschinen, die sie indexieren. Dadurch können Nutzer über Suchanfragen relevante Informationen im Internet finden. **
Top-Angebote
Produkte zum Begriff Algorithmus:
-
Umbreit Analyse von funktionellen MRI-Daten mit Hilfe eines Clustering-Algorithmus (Deutsch, Softcover, Ramesh Babu N) (63605592)Umbreit Analyse von funktionellen MRI-Daten mit Hilfe eines Clustering-Algorithmus (Deutsch, Softcover, Ramesh Babu N) (63605592)35,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Untersuchung, Implementierung und Einsatz des Levenberg-Marquardt-Algorithmus zur Analyse von Chip-Fertigungsdaten, Taschenbuch von Daniel Weisskopf,Untersuchung, Implementierung Und Einsatz Des Levenberg-marquardt-algorithmus Zur Analyse Von Chip-fertigungsdaten, Taschenbuch Von Daniel Weisskopf, Grin, 978-3-8386-1645-2, Seitenanzahl: 11238,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Zweig, Katharina: Ein Algorithmus hat kein TaktgefühlEin Algorithmus hat kein Taktgefühl , Wo künstliche Intelligenz sich irrt, warum uns das betrifft und was wir dagegen tun können , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Auflage: Originalausgabe, Erscheinungsjahr: 20191014, Produktform: Kartoniert, Titel der Reihe: Künstliche Intelligenz (Heyne)##, Autoren: Zweig, Katharina, Auflage/Ausgabe: Originalausgabe, Seitenzahl/Blattzahl: 320, Abbildungen: Illus im Text, Keyword: algorithmen; artificial intelligence; bestseller; bestsellerliste; buch; bücher; datenklau; demokratie; digitalisierung; facebook; google; internet; künstliche intelligenz; persönliche daten; roboter; spiegel bestseller; spiegel-bestseller; spiegelbestseller, Fachschema: Internet / Politik, Gesellschaft~Medientheorie~Medienwissenschaft~EDV / Gesellschaft u. Computer~EDV / Theorie / Recht~Recht (EDV)~Internet~Surfen (Internet)~Algorithmus~Datenschutz~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI, Fachkategorie: Ethische und soziale Fragen der IT~Rechtliche Fragen der IT~Internet, allgemein~Algorithmen und Datenstrukturen~Datenschutz~Künstliche Intelligenz, Thema: Verstehen, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Medienwissenschaften: Internet, digitale Medien und Gesellschaft, Thema: Optimieren, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Heyne Verlag, Verlag: Heyne Verlag, Verlag: Heyne, Länge: 206, Breite: 136, Höhe: 33, Gewicht: 417, Produktform: Klappenbroschur, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, eBook EAN: 9783641250232, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 193169520,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert die Indexierung und der Algorithmus einer Website-Suchmaschine? Welche Faktoren bestimmen die Relevanz der Suchergebnisse?
Die Indexierung einer Website-Suchmaschine erfolgt durch das Durchsuchen und Speichern von Webseiteninhalten in einer Datenbank. Der Algorithmus einer Suchmaschine bestimmt die Relevanz der Suchergebnisse anhand von Faktoren wie Keywords, Backlinks, Nutzerverhalten und Aktualität der Inhalte. Die Suchmaschine zeigt dann die Ergebnisse basierend auf diesen Faktoren in einer bestimmten Reihenfolge an. **
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
Ähnliche Suchbegriffe für Algorithmus
-
Ein vorgeschlagener neuer Algorithmus für die Analyse des hierarchischen Clusterns, Taschenbuch von Saravanan Devaraj, Verlag Unser Wissen,Ein Vorgeschlagener Neuer Algorithmus Für Die Analyse Des Hierarchischen Clusterns, Taschenbuch Von Saravanan Devaraj, Verlag Unser Wissen, 978-620-6-53222-4, Seitenanzahl: 5635,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
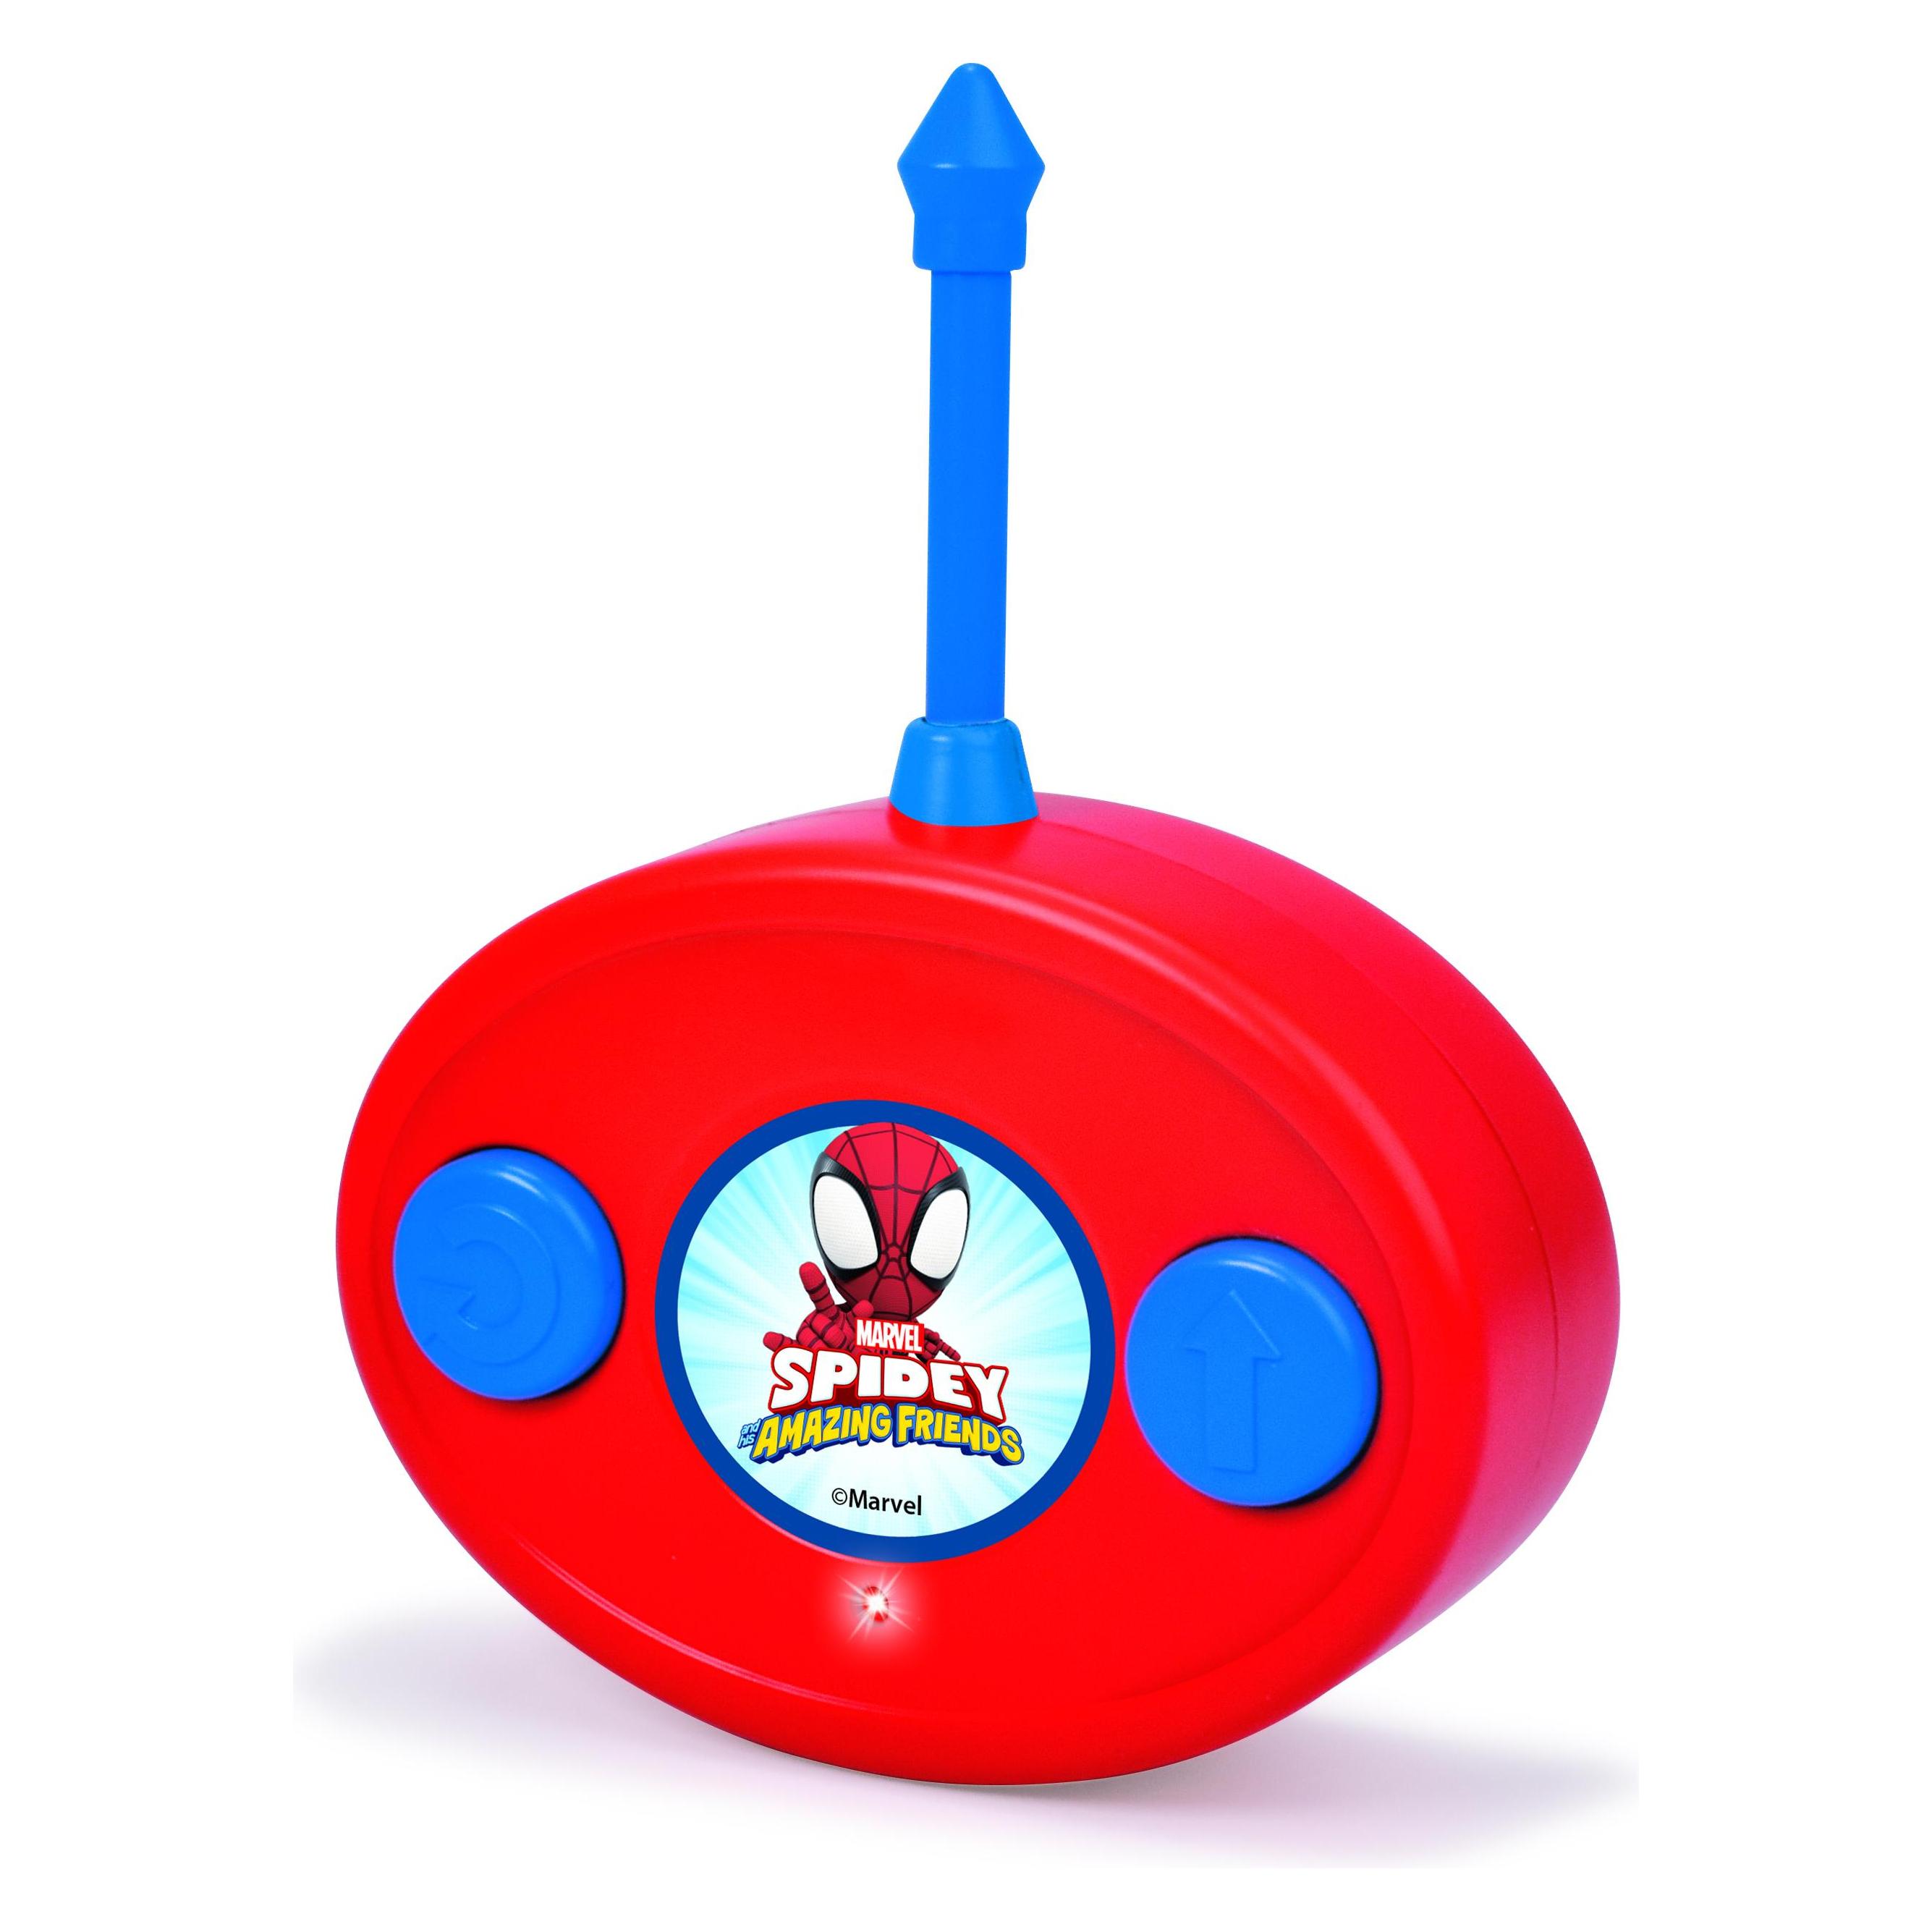
Marvel RC Spidey Web CrawlerFerngesteuertes Auto RC Spidey Web Crawler bietet 1-Kanal-27 MHz-Steuerung und Fahrfunktionen für Vorwärtsfahren und Rückwärtslenken. Dieses Marvel Spidey RC-Auto ist für Kinder ab 3 Jahren konzipiert und hat eine Länge von 17 cm für einfaches Spielen drinnen und unkomplizierte Handhabung. Marvel Spidey Thema 1-Kanal-Steuerung 27 MHz Fernsteuerfrequenz Fährt vorwärts Lenkt rückwärts Länge: 17 cm Empfohlenes Alter: ab 3 Jahren Einfache Steuerung und kompakte Größe machen es zu einem spaßigen, leicht zu bedienenden Marvel Spidey Fahrzeug für den Alltag.29,73 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Effizienter Ranking-Algorithmus für verteilten mehrsprachigen Index, Taschenbuch von Manju More E.,G. Sunil Kumar, Verlag Unser Wissen,Effizienter Ranking-algorithmus Für Verteilten Mehrsprachigen Index, Taschenbuch Von Manju More E.,g. Sunil Kumar, Verlag Unser Wissen, 978-620-7-33614-2, Seitenanzahl: 9260,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Internetinhalten?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links folgen und Webseiten analysieren. Sie sammeln Informationen über Webseiten und senden sie an Suchmaschinen, die sie indexieren. Dadurch können Nutzer über Suchanfragen relevante Informationen im Internet finden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.