Domain web-crawler.de kaufen?
Wir ziehen mit dem Projekt
web-crawler.de um.
Sind Sie am Kauf der Domain
web-crawler.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain web-crawler.de kaufen?
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
Wie kann man eine .NET Web API auslösen?
Eine .NET Web API kann auf verschiedene Arten ausgelöst werden. Man kann sie über einen Webbrowser aufrufen, indem man die entsprechende URL eingibt. Man kann sie auch über eine andere Anwendung aufrufen, indem man eine HTTP-Anfrage an die API sendet. Dies kann mit Hilfe von Tools wie Postman oder über den Code einer anderen Anwendung erfolgen. **
Ähnliche Suchbegriffe für Springer-Pro-ASP-NET
Top-Angebote
Produkte zum Begriff Springer-Pro-ASP-NET:
-
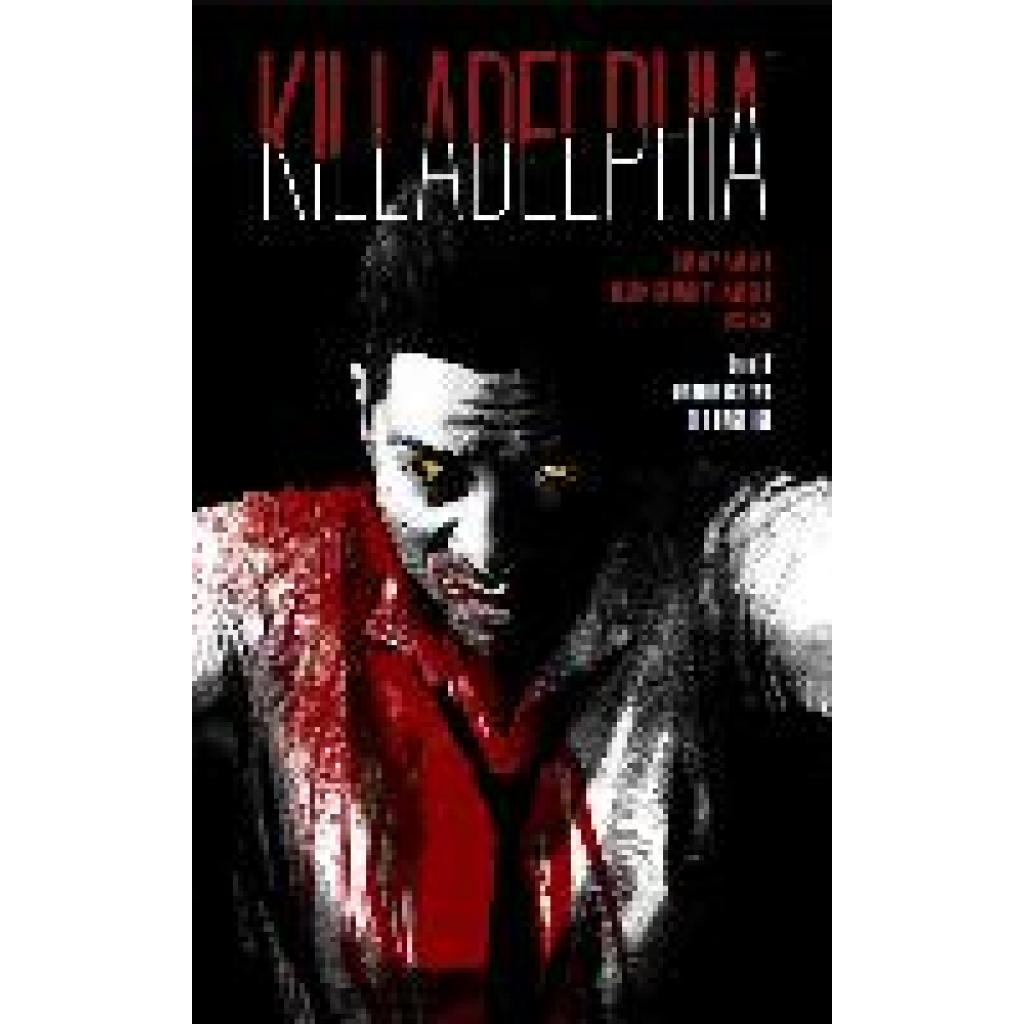
Net, Luis: Killadelphia 3Killadelphia 3 , Daheim ist, wo der Hass ist , Differentiallager > Differentiale & Teile , Erscheinungsjahr: 20240131, Produktform: Leinen, Beilage: limitert auf 333 Exemplare, Autoren: Alexander, Jason Alexander~Barnes, Rodney~Net, Luis, Seitenzahl/Blattzahl: 192, Abbildungen: 192 farbige Abbildungen, Keyword: Comic; Vampire; Horror; Geschichte, Fachschema: Comic, Altersempfehlung / Lesealter: 18, ab Alter: 16, bis Alter: 100, Warengruppe: HC/Belletristik/Humor/Cartoons/Comics, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 246, Breite: 165, Höhe: 22, Gewicht: 650, Produktform: Gebunden, Genre: Belletristik,34,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
-
Was bedeutet "ASP"?
ASP steht für "Active Server Pages" und ist eine Technologie von Microsoft, die es ermöglicht, dynamische Webseiten zu erstellen. Mit ASP können Datenbankabfragen durchgeführt, Formulare verarbeitet und Inhalte dynamisch generiert werden. ASP wird häufig in Verbindung mit der Programmiersprache VBScript verwendet. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **

Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
Top-Angebote
Produkte zum Begriff Springer-Pro-ASP-NET:
-
Net, Luis: Killadelphia 3Killadelphia 3 , Daheim ist, wo der Hass ist , Differentiallager > Differentiale & Teile , Erscheinungsjahr: 20240131, Produktform: Leinen, Beilage: limitert auf 333 Exemplare, Autoren: Alexander, Jason Alexander~Barnes, Rodney~Net, Luis, Seitenzahl/Blattzahl: 192, Abbildungen: 192 farbige Abbildungen, Keyword: Comic; Vampire; Horror; Geschichte, Fachschema: Comic, Altersempfehlung / Lesealter: 18, ab Alter: 16, bis Alter: 100, Warengruppe: HC/Belletristik/Humor/Cartoons/Comics, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 246, Breite: 165, Höhe: 22, Gewicht: 650, Produktform: Gebunden, Genre: Belletristik,34,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
-
Wie kann man eine .NET Web API auslösen?
Eine .NET Web API kann auf verschiedene Arten ausgelöst werden. Man kann sie über einen Webbrowser aufrufen, indem man die entsprechende URL eingibt. Man kann sie auch über eine andere Anwendung aufrufen, indem man eine HTTP-Anfrage an die API sendet. Dies kann mit Hilfe von Tools wie Postman oder über den Code einer anderen Anwendung erfolgen. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
Ähnliche Suchbegriffe für Springer-Pro-ASP-NET
-
Was bedeutet "ASP"?
ASP steht für "Active Server Pages" und ist eine Technologie von Microsoft, die es ermöglicht, dynamische Webseiten zu erstellen. Mit ASP können Datenbankabfragen durchgeführt, Formulare verarbeitet und Inhalte dynamisch generiert werden. ASP wird häufig in Verbindung mit der Programmiersprache VBScript verwendet. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.