Domain web-crawler.de kaufen?
Wir ziehen mit dem Projekt
web-crawler.de um.
Sind Sie am Kauf der Domain
web-crawler.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain web-crawler.de kaufen?
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **


Ähnliche Suchbegriffe für Phishing
Top-Angebote
Produkte zum Begriff Phishing:
-
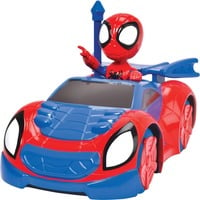
Marvel RC Spidey Web CrawlerFerngesteuertes Auto RC Spidey Web Crawler bietet 1-Kanal-27 MHz-Steuerung und Fahrfunktionen für Vorwärtsfahren und Rückwärtslenken. Dieses Marvel Spidey RC-Auto ist für Kinder ab 3 Jahren konzipiert und hat eine Länge von 17 cm für einfaches Spielen drinnen und unkomplizierte Handhabung. Marvel Spidey Thema 1-Kanal-Steuerung 27 MHz Fernsteuerfrequenz Fährt vorwärts Lenkt rückwärts Länge: 17 cm Empfohlenes Alter: ab 3 Jahren Einfache Steuerung und kompakte Größe machen es zu einem spaßigen, leicht zu bedienenden Marvel Spidey Fahrzeug für den Alltag.29,72 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **

Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Internetinhalten?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links folgen und Webseiten analysieren. Sie sammeln Informationen über Webseiten und senden sie an Suchmaschinen, die sie indexieren. Dadurch können Nutzer über Suchanfragen relevante Informationen im Internet finden. **
Was ist ein Phishing-Link?
Ein Phishing-Link ist ein betrügerischer Link, der dazu dient, persönliche Informationen wie Passwörter, Kreditkartennummern oder Bankdaten von ahnungslosen Nutzern zu stehlen. Diese Links werden oft in gefälschten E-Mails oder Nachrichten versendet und sehen täuschend echt aus, um die Empfänger dazu zu verleiten, auf den Link zu klicken und ihre sensiblen Daten preiszugeben. Es ist wichtig, solche Links zu erkennen und zu vermeiden, um sich vor Phishing-Angriffen zu schützen. **
Top-Angebote
Produkte zum Begriff Phishing:
-
Kaspersky Threat Data Feeds - Phishing URLKaspersky Threat Data Feeds – Phishing URL In der heutigen vernetzten Welt stellen Phishing-Angriffe eine der größten Cyberbedrohungen für Unternehmen und Privatpersonen dar. Cyberkriminelle nutzen bösartige Websites, um Benutzerdaten zu stehlen, vertrauliche Informationen auszuspionieren und schädliche Aktivitäten auszuführen. Um sich gegen diese Angriffe zu wappnen, benötigen Unternehmen kontinuierlich aktualisierte Informationen über gefährliche URLs. **Kaspersky Threat Data Feeds – Phishing URL** bietet eine umfassende und ständig aktualisierte Datenquelle über bekannte Phishing-URLs, die es Unternehmen ermöglicht, potenziell schädliche Websites zu identifizieren und ihre Systeme effektiv vor Phishing-Angriffen zu schützen. Überblick über Kaspersky Threat Data Feeds – Phishing URL Der **Kaspersky Threat Data Feeds – Phishing URL**-Dienst stellt Unternehmen eine stetig aktualisierte Datenbank über URLs zur Verfügung, die als Phishing-Websites identifiziert wurden. Diese Feeds umfassen Details über verdächtige und bösartige Websites, die darauf abzielen, Benutzerdaten zu stehlen oder Schadsoftware zu verbreiten. Durch die Integration dieser Informationen in bestehende Sicherheitslösungen können Unternehmen ihre Abwehrmechanismen stärken und die Wahrscheinlichkeit von Cyberangriffen erheblich verringern. Hauptfunktionen Umfassende Phishing-URL-Daten: Bereitstellung einer ständig aktualisierten Datenbank mit Phishing-URLs, die in Echtzeit Bedrohungen erkennen und blockieren hilft. Zusätzliche Bedrohungsinformationen: Zu jeder URL werden relevante Details wie Kategorie, Bedrohungslevel und geografische Herkunft geliefert. Nahtlose Integration: Einfache Implementierung der Datenfeeds in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitssysteme. Minimierung von Fehlalarmen: Durch die Bereitstellung präziser Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams gesteigert. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor sie in das System eindringen können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Phishing: Durch den Zugang zu aktuellen Bedrohungsdaten können Unternehmen schädliche Phishing-URLs schnell erkennen und blockieren. Optimierte Sicherheitsstrategie: Durch aktuelle Bedrohungsdaten können Unternehmen proaktive Sicherheitsmaßnahmen entwickeln und Sicherheitslücken schließen. Effizienzsteigerung: Die Reduzierung von Fehlalarmen ermöglicht es den Sicherheitsteams, sich auf echte Bedrohungen zu konzentrieren und schneller zu reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Phishing URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Phishing URL Verhinderung von Identitätsdiebstahl: Durch Blockierung von Phishing-URLs können Unternehmen sicherstellen, dass Mitarbeiter und Kunden nicht auf gefälschte Websites zugreifen. Schutz vor Datendiebstahl: Phishing-Angriffe, die darauf abzielen, sensible Daten zu sammeln, können frühzeitig erkannt und verhindert werden. Erhöhung der Netzwerksicherheit: Durch die Identifizierung und Blockierung verdächtiger URLs kann das Unternehmensnetzwerk besser geschützt werden.35958,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Dittmar, Jakob F.: Comic-AnalyseComic-Analyse , Alle Bildgeschichten erzählen im Prinzip mit demselben bildlichen und textlichen Inventar, seien sie komplex oder simpel, gedruckt, hybrid oder digital publiziert. Die Narration im Comic wird immer aus visuellen Einheiten konstruiert. Entsprechend bietet dieses Buch eine systematische Grundlage für die Beschreibung und Analyse von Comics. Zugleich erleichtert es reflektierte Entscheidungen bei der konkreten Gestaltung von Comics, sowohl auf Ebene einzelner Bilder und ihrer Elemente als auch auf Ebene der Seitenkomposition. Die Elemente von Comics werden isoliert beschrieben und untersucht, um ihr Zusammenwirken genauer zu bestimmen, denn sowohl die Sequenzkonstruktion als auch die Art und Weise, in der einzelne Elemente dabei verwendet werden, machen das Medium Comic und seine Erzählformen aus. Dabei wird die zugrunde liegende Funktionsweise aller Bildgeschichten deutlich - zugleich aber auch die Varianz, die individuelle Bildgeschichten aufweisen und den persönlichen Stil von Comicschaffenden ausmachen können. Diese 3. Auflage wurde grundlegend überarbeitet und erweitert. , Kabel, Kabelbäume & Steckverbinder > Audio, Kommunikation & Navigation , Auflage: 3., überarbeitete Auflage, Erscheinungsjahr: 20250410, Autoren: Dittmar, Jakob F., Edition: REV, Auflage: 25003, Auflage/Ausgabe: 3., überarbeitete Auflage, Seitenzahl/Blattzahl: 276, Abbildungen: 40 s/w Abbildungen, Keyword: Bildanalyse; Comic; Graphic Novel; Manga; Textanalyse; Zeichen, Fachschema: Comic / Theorie, Rezeption, Kunst~Medientheorie~Medienwissenschaft~Analyse / Textanalyse~Analyse (literarisch, sprachlich) / Textanalyse~Textanalyse~Kunst, Fachkategorie: Malerei und Gemälde~Literaturwissenschaft, allgemein, Warengruppe: HC/Literaturwissenschaft/Allgemeines, Lexika, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 240, Breite: 170, Höhe: 17, Gewicht: 472, Produktform: Klappenbroschur, Genre: Geisteswissenschaften/Kunst/Musik,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Marvel RC Spidey Web CrawlerFerngesteuertes Auto RC Spidey Web Crawler bietet 1-Kanal-27 MHz-Steuerung und Fahrfunktionen für Vorwärtsfahren und Rückwärtslenken. Dieses Marvel Spidey RC-Auto ist für Kinder ab 3 Jahren konzipiert und hat eine Länge von 17 cm für einfaches Spielen drinnen und unkomplizierte Handhabung. Marvel Spidey Thema 1-Kanal-Steuerung 27 MHz Fernsteuerfrequenz Fährt vorwärts Lenkt rückwärts Länge: 17 cm Empfohlenes Alter: ab 3 Jahren Einfache Steuerung und kompakte Größe machen es zu einem spaßigen, leicht zu bedienenden Marvel Spidey Fahrzeug für den Alltag.29,72 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
Was sind die potenziellen Vorteile und Risiken von Web-Crawling für die Datenextraktion und -analyse?
Potenzielle Vorteile von Web-Crawling für die Datenextraktion und -analyse sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Automatisierung von Prozessen. Risiken sind unter anderem rechtliche Probleme aufgrund von Urheberrechtsverletzungen und die Gefahr von fehlerhaften oder veralteten Datenquellen. Es ist wichtig, ethische Richtlinien zu beachten und sicherzustellen, dass die gesammelten Daten korrekt und zuverlässig sind. **
-
Was sind die Vorteile von Web-Crawling für die Datenextraktion?
Web-Crawling ermöglicht die automatische Extraktion von großen Mengen an Daten aus dem Internet. Es spart Zeit und Ressourcen, da Informationen schnell und effizient gesammelt werden können. Zudem können mithilfe von Web-Crawling aktuelle und relevante Daten für Analysen und Entscheidungsfindungen gewonnen werden. **
-
Was sind die gängigsten Methoden und Tools für das Web-Crawling und wie kann diese Technik zur Datenextraktion und -analyse eingesetzt werden?
Die gängigsten Methoden für das Web-Crawling sind das Schreiben von eigenen Crawlern oder die Verwendung von bereits existierenden Tools wie Scrapy oder BeautifulSoup. Diese Techniken können zur Extraktion von strukturierten Daten wie Preisen, Bewertungen oder Kontaktdaten von Websites genutzt werden. Die extrahierten Daten können dann für verschiedene Zwecke wie Marktanalysen, Wettbewerbsforschung oder Lead-Generierung verwendet werden. **
-
Was sind die Vorteile und Herausforderungen des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten?
Die Vorteile des Web-Crawlings für die Datenextraktion und Analyse von Internetinhalten sind die Möglichkeit, große Mengen an Daten schnell und effizient zu sammeln, sowie die Fähigkeit, Informationen aus verschiedenen Quellen zu aggregieren und zu analysieren. Die Herausforderungen liegen in der Notwendigkeit, mit der ständigen Veränderung und Aktualisierung von Webinhalten Schritt zu halten, sowie in der Gefahr von Fehlinformationen und ungenauen Daten aufgrund von fehlerhaften Crawling-Algorithmen oder unzuverlässigen Quellen. **
Ähnliche Suchbegriffe für Phishing
-
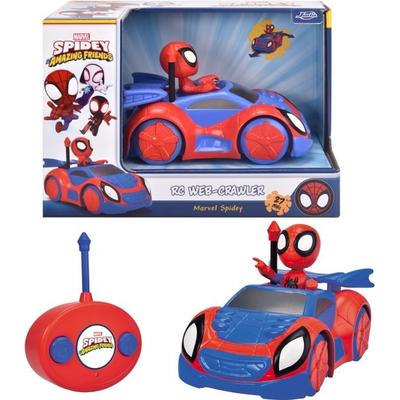
RC Spidey Web Crawler 1:24Jada Toys Spidey Rc Web Crawler (17 Cm) - Ferngesteuertes Auto Zu Marvel Spidey Und Seine Super-freunde, Spielzeug-auto Mit Fernbedienung Für Kinder Ab 3 Jahre, Max. 6.5 Km/h • Offizielles Spidey Spielzeug - Inspiriert Von Den Abenteuern Der...29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Phishing URLKaspersky Threat Data Feeds – Phishing URL In der heutigen vernetzten Welt stellen Phishing-Angriffe eine der größten Cyberbedrohungen für Unternehmen und Privatpersonen dar. Cyberkriminelle nutzen bösartige Websites, um Benutzerdaten zu stehlen, vertrauliche Informationen auszuspionieren und schädliche Aktivitäten auszuführen. Um sich gegen diese Angriffe zu wappnen, benötigen Unternehmen kontinuierlich aktualisierte Informationen über gefährliche URLs. **Kaspersky Threat Data Feeds – Phishing URL** bietet eine umfassende und ständig aktualisierte Datenquelle über bekannte Phishing-URLs, die es Unternehmen ermöglicht, potenziell schädliche Websites zu identifizieren und ihre Systeme effektiv vor Phishing-Angriffen zu schützen. Überblick über Kaspersky Threat Data Feeds – Phishing URL Der **Kaspersky Threat Data Feeds – Phishing URL**-Dienst stellt Unternehmen eine stetig aktualisierte Datenbank über URLs zur Verfügung, die als Phishing-Websites identifiziert wurden. Diese Feeds umfassen Details über verdächtige und bösartige Websites, die darauf abzielen, Benutzerdaten zu stehlen oder Schadsoftware zu verbreiten. Durch die Integration dieser Informationen in bestehende Sicherheitslösungen können Unternehmen ihre Abwehrmechanismen stärken und die Wahrscheinlichkeit von Cyberangriffen erheblich verringern. Hauptfunktionen Umfassende Phishing-URL-Daten: Bereitstellung einer ständig aktualisierten Datenbank mit Phishing-URLs, die in Echtzeit Bedrohungen erkennen und blockieren hilft. Zusätzliche Bedrohungsinformationen: Zu jeder URL werden relevante Details wie Kategorie, Bedrohungslevel und geografische Herkunft geliefert. Nahtlose Integration: Einfache Implementierung der Datenfeeds in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitssysteme. Minimierung von Fehlalarmen: Durch die Bereitstellung präziser Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams gesteigert. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor sie in das System eindringen können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Phishing: Durch den Zugang zu aktuellen Bedrohungsdaten können Unternehmen schädliche Phishing-URLs schnell erkennen und blockieren. Optimierte Sicherheitsstrategie: Durch aktuelle Bedrohungsdaten können Unternehmen proaktive Sicherheitsmaßnahmen entwickeln und Sicherheitslücken schließen. Effizienzsteigerung: Die Reduzierung von Fehlalarmen ermöglicht es den Sicherheitsteams, sich auf echte Bedrohungen zu konzentrieren und schneller zu reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Phishing URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Phishing URL Verhinderung von Identitätsdiebstahl: Durch Blockierung von Phishing-URLs können Unternehmen sicherstellen, dass Mitarbeiter und Kunden nicht auf gefälschte Websites zugreifen. Schutz vor Datendiebstahl: Phishing-Angriffe, die darauf abzielen, sensible Daten zu sammeln, können frühzeitig erkannt und verhindert werden. Erhöhung der Netzwerksicherheit: Durch die Identifizierung und Blockierung verdächtiger URLs kann das Unternehmensnetzwerk besser geschützt werden.20258,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Internetinhalten?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links folgen und Webseiten analysieren. Sie sammeln Informationen über Webseiten und senden sie an Suchmaschinen, die sie indexieren. Dadurch können Nutzer über Suchanfragen relevante Informationen im Internet finden. **
-
Was ist ein Phishing-Link?
Ein Phishing-Link ist ein betrügerischer Link, der dazu dient, persönliche Informationen wie Passwörter, Kreditkartennummern oder Bankdaten von ahnungslosen Nutzern zu stehlen. Diese Links werden oft in gefälschten E-Mails oder Nachrichten versendet und sehen täuschend echt aus, um die Empfänger dazu zu verleiten, auf den Link zu klicken und ihre sensiblen Daten preiszugeben. Es ist wichtig, solche Links zu erkennen und zu vermeiden, um sich vor Phishing-Angriffen zu schützen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.